创建自定义MCP插件示例
功能说明
本文介绍如何创建自定义 MCP 类型插件,实现天气查询功能。
自定义 MCP 无需后端改造为标准 MCP 服务,可直接基于现有的天气 API 进行配置;
配置完成后,智能体能够理解用户的自然语言提问,自动识别调用该天气工具、填充入参并获取实时天气数据,最终将查询结果整理后回复用户。
1.新建插件
进入百数AI模式 >> 智能体开发 >> MCP >> +MCP,创建私有 MCP
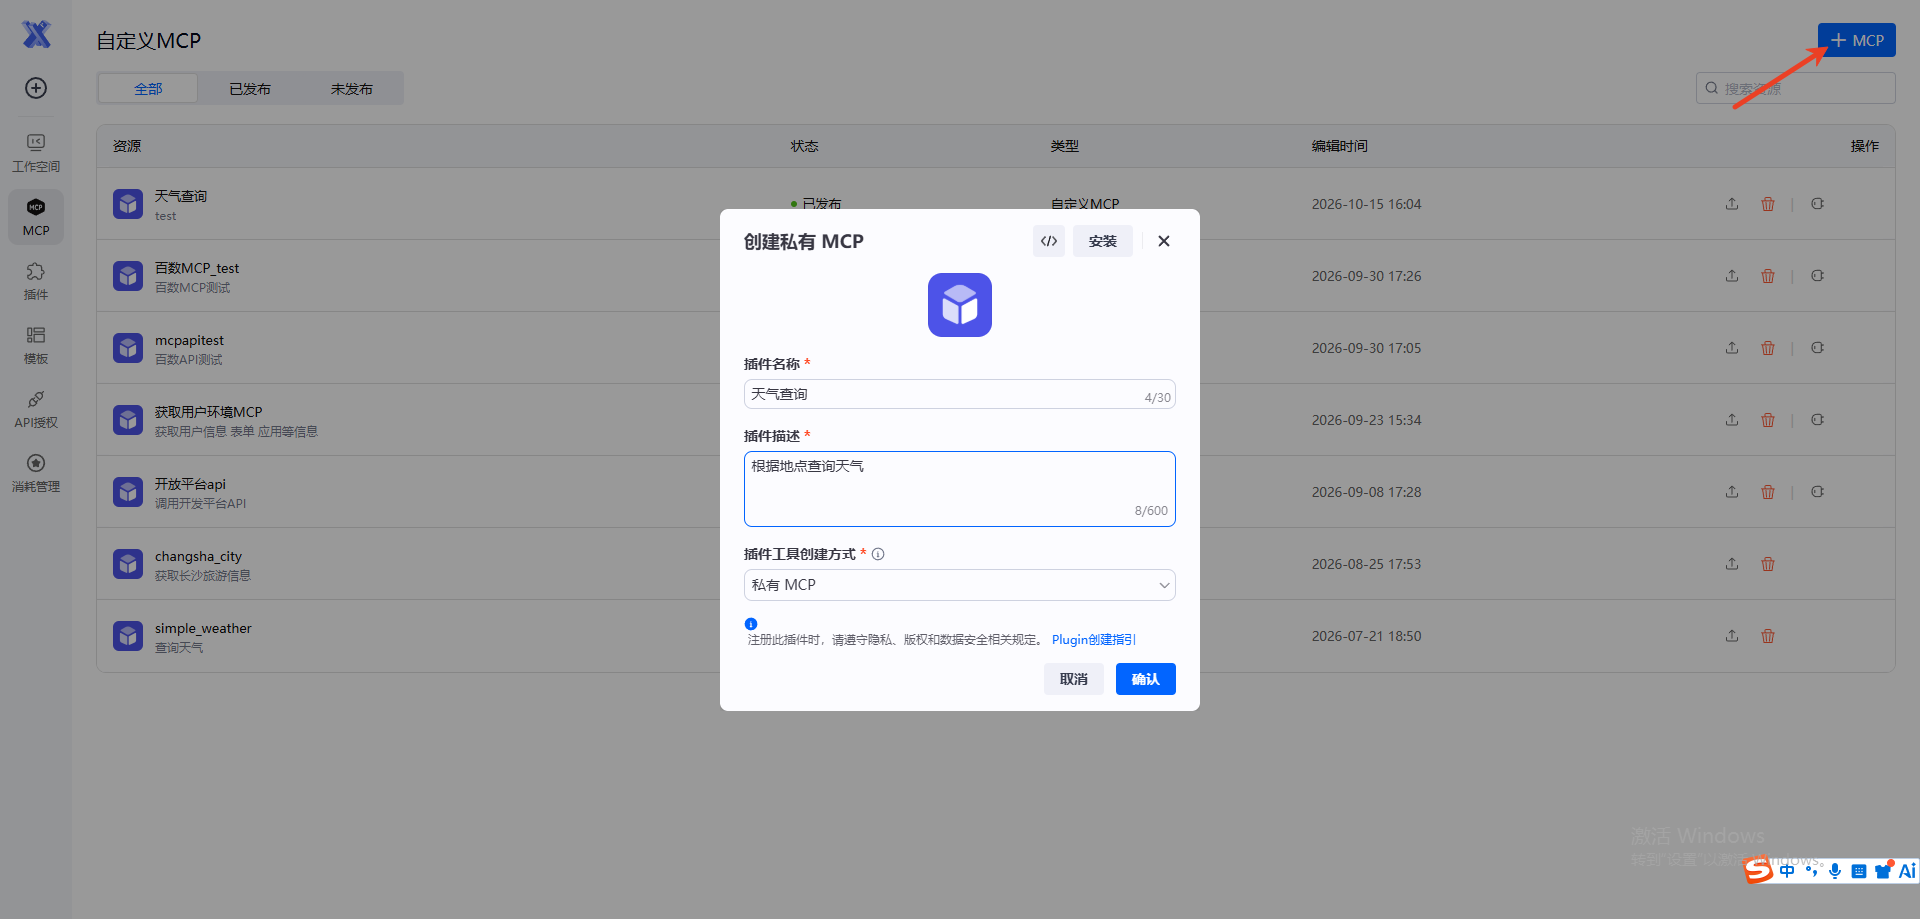
配置参数如下:
| 参数名称 | 值 |
|---|---|
| 插件名称 | 天气查询,自定义值 |
| 插件描述 | 自定义,描述插件的功能 |
| 插件工具创建方式 | 私有MCP |
2.代码编辑
编写Python代码,实现天气查询功能。
可以使用AI来辅助修改代码。
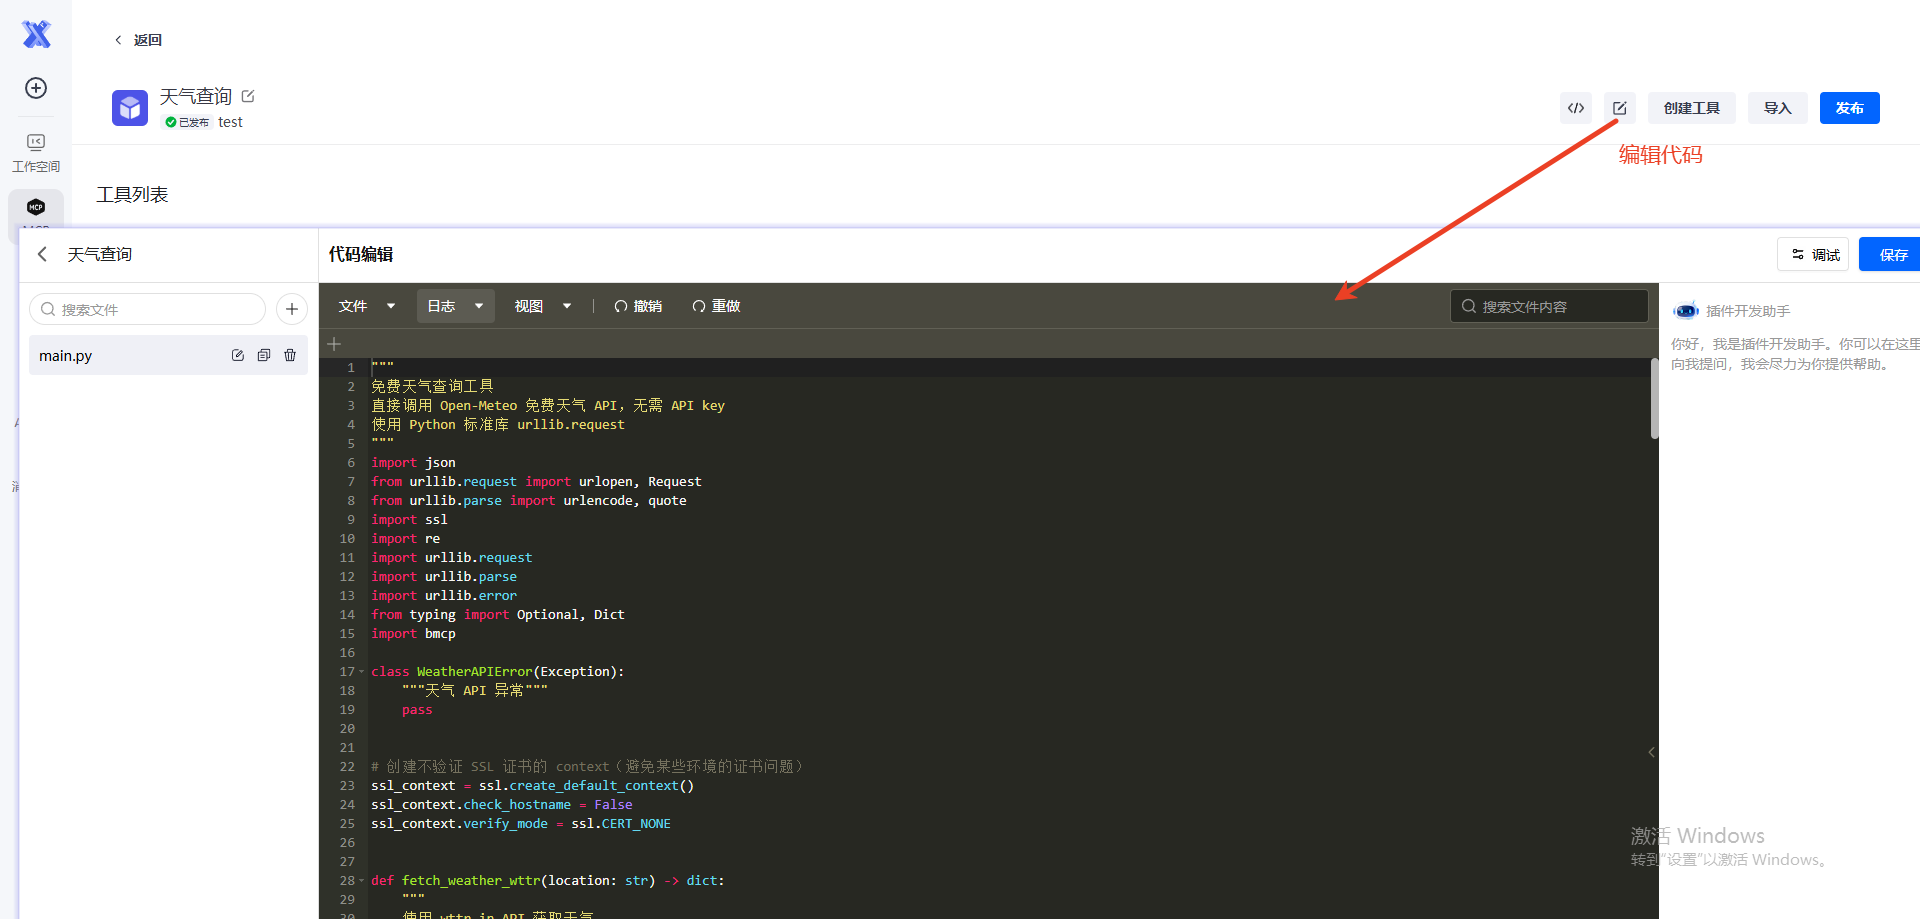
代码开发过程中,可以点击调试来试运行代码,调试通过代表符合平台规范。
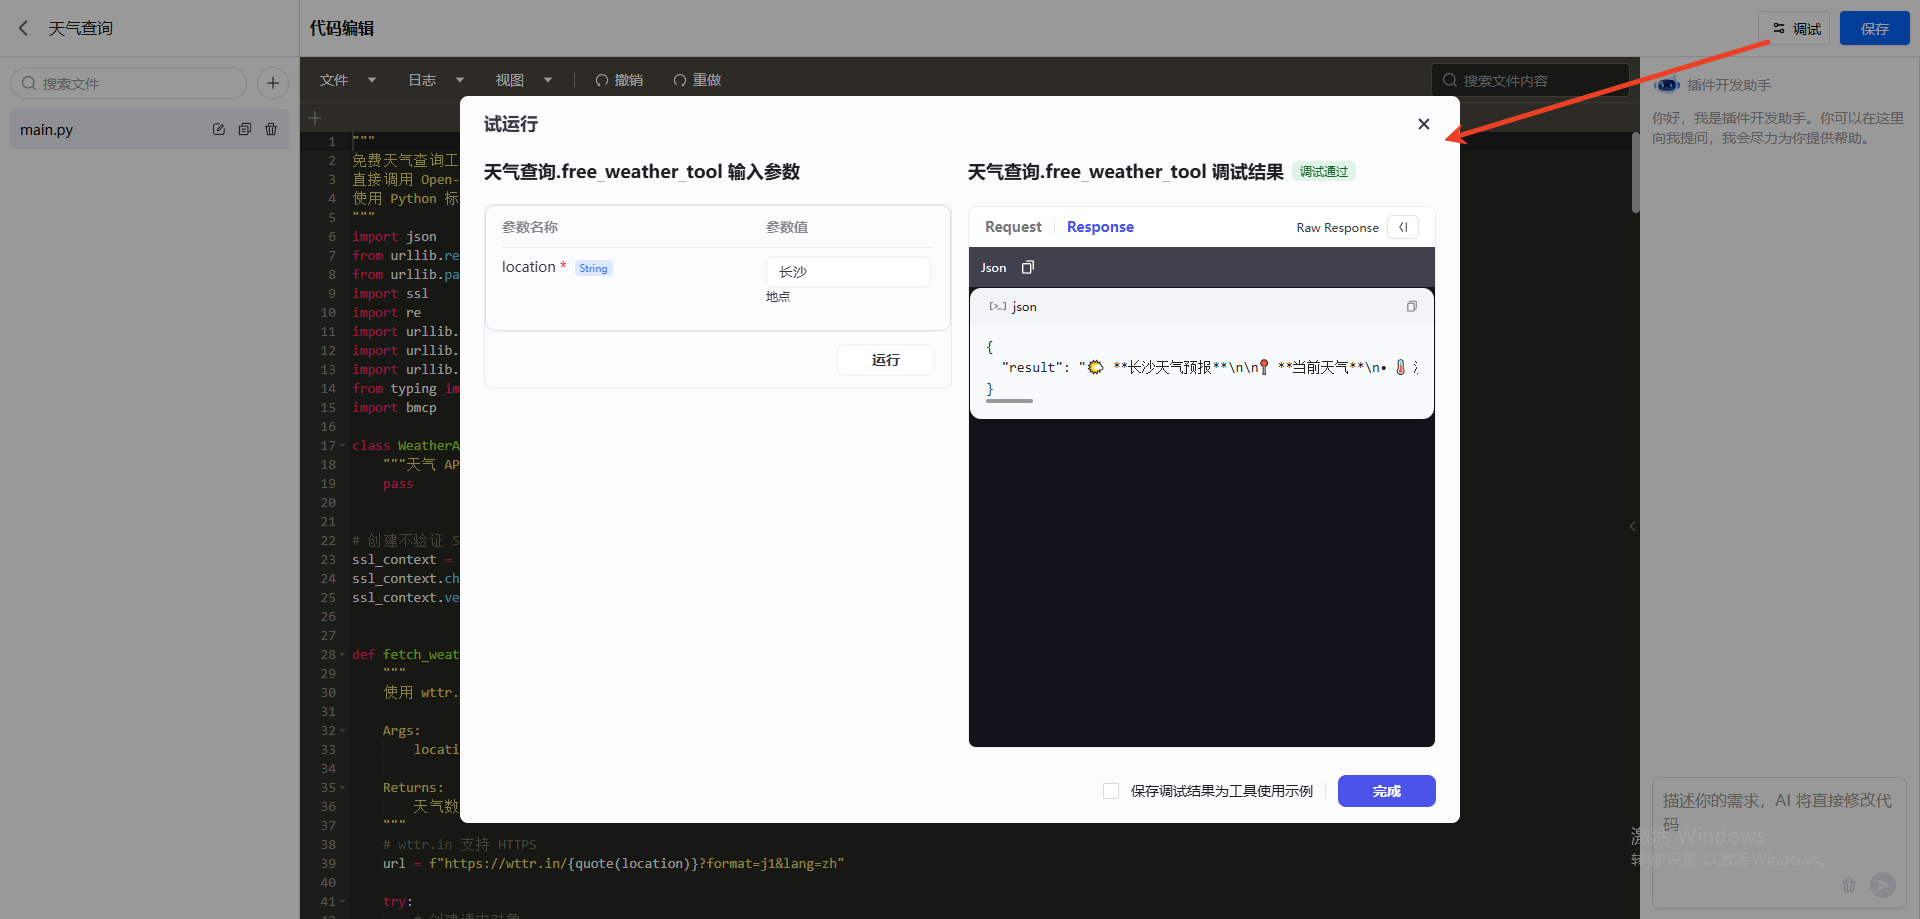
天气查询工具源码如下:
"""
免费天气查询工具
直接调用 Open-Meteo 免费天气 API,无需 API key
使用 Python 标准库 urllib.request
"""
import json
from urllib.request import urlopen, Request
from urllib.parse import urlencode, quote
import ssl
import re
import urllib.request
import urllib.parse
import urllib.error
from typing import Optional, Dict
import bmcp

class WeatherAPIError(Exception):
    """天气 API 异常"""
    pass


# 创建不验证 SSL 证书的 context(避免某些环境的证书问题)
ssl_context = ssl.create_default_context()
ssl_context.check_hostname = False
ssl_context.verify_mode = ssl.CERT_NONE


def fetch_weather_wttr(location: str) -> dict:
    """
    使用 wttr.in API 获取天气

    Args:
        location: 城市名称

    Returns:
        天气数据字典
    """
    # wttr.in 支持 HTTPS
    url = f"https://wttr.in/{quote(location)}?format=j1&lang=zh"

    try:
        # 创建请求对象
        request = Request(url)
        request.add_header('User-Agent', 'Mozilla/5.0')
        request.add_header('Accept', 'application/json')

        # 发送请求(使用 ssl_context 避免证书验证问题)
        response = urlopen(request, timeout=30, context=ssl_context)

        # 读取并解析 JSON
        data = response.read().decode('utf-8')
        return json.loads(data)

    except Exception as e:
        raise WeatherAPIError(f"请求失败:{str(e)}")


def format_weather_data(data: dict, location: str) -> str:
    """
    格式化天气数据为易读的字符串

    Args:
        data: wttr.in 返回的天气数据
        location: 城市名称

    Returns:
        格式化的天气信息字符串
    """
    try:
        # 获取当前天气
        current = data.get('current_condition', [{}])[0]

        # 提取当前天气信息
        temp_c = current.get('temp_C', 'N/A')
        feels_like = current.get('FeelsLikeC', 'N/A')
        humidity = current.get('humidity', 'N/A')
        weather_desc = current.get('lang_zh', [{}])[0].get('value', current.get('weatherDesc', [{}])[0].get('value', '未知'))
        windspeed = current.get('windspeedKmph', 'N/A')
        winddir = current.get('winddir16Point', 'N/A')
        cloudcover = current.get('cloudcover', 'N/A')

        # 获取未来天气
        weather_forecast = data.get('weather', [])

        result = f"""🌤️ **{location}天气预报**

📍 **当前天气**
• 🌡️ 温度:{temp_c}°C(体感 {feels_like}°C)
• 🌥️ 天气:{weather_desc}
• 💧 湿度:{humidity}%
• ☁️ 云量:{cloudcover}%
• 🌬️ 风速:{windspeed} km/h({winddir}风)

📅 **未来3天预报**
"""

        # 添加每日预报
        weekdays = ['周一', '周二', '周三', '周四', '周五', '周六', '周日']

        for i, day in enumerate(weather_forecast[:3]):
            date = day.get('date', '')
            max_temp = day.get('maxtempC', 'N/A')
            min_temp = day.get('mintempC', 'N/A')

            # 获取天气描述(优先使用中文)
            hourly = day.get('hourly', [])
            if hourly:
                # 使用中午12点的天气作为当天代表
                noon_hour = hourly[4] if len(hourly) > 4 else hourly[0]
                weather_desc = noon_hour.get('lang_zh', [{}])[0].get('value', '未知')
                precip_prob = noon_hour.get('chanceofrain', '0')
            else:
                weather_desc = '未知'
                precip_prob = '0'

            # 解析日期获取星期
            parts = date.split('-')
            if len(parts) == 3:
                year, month, day_num = parts
                # 简单计算星期(基于 2026-01-01 是周四)
                base_weekday = 3
                days_in_month = [31, 28, 31, 30, 31, 30, 31, 31, 30, 31, 30, 31]
                total_days = sum(days_in_month[:int(month)-1]) + int(day_num) - 1
                weekday = weekdays[(base_weekday + total_days) % 7]
            else:
                weekday = ''

            day_label = "今天" if i == 0 else ("明天" if i == 1 else weekday)

            result += f"""
**{date} {day_label}**
• 🌡️ 温度:{min_temp}°C ~ {max_temp}°C
• 🌥️ 天气:{weather_desc}
• 🌧️ 降雨概率:{precip_prob}%
"""

        result += """
📊 数据来源:wttr.in(免费API)
✨ 无需 API key,完全免费使用!
"""

        return result

    except Exception as e:
        raise WeatherAPIError(f"格式化天气数据失败:{str(e)}")


def free_weather_query(location: str) -> str:
    """
    使用免费 wttr.in API 查询天气信息,无需 API key,无需 SSL。

    Args:
        location: 城市名称,例如"北京"、"上海"、"东京"等

    Returns:
        格式化的天气信息,包括当前天气、未来3天预报、温度、湿度、风速等
    """
    try:
        # 获取天气数据
        weather_data = fetch_weather_wttr(location)

        # 格式化输出
        # return format_weather_data(weather_data, location)
        return {"result": format_weather_data(weather_data, location)}
    except WeatherAPIError as e:
        return {"result": f"{str(e)}"}
    except Exception as e:
        return {"result": f"查询天气时发生错误:{str(e)}"}


# def free_weather_query(location):
#     """
#     使用免费 Open-Meteo API 查询天气信息,无需 API key。

#     Args:
#         location: 城市名称,例如"北京"、"上海"、"东京"等

#     Returns:
#         格式化的天气信息,包括当前天气、未来3天预报、温度、湿度、风速等
#     """

#     message = f"""
#     **5月20日 长沙**
#     • 🌡️ 温度:27°C ~ 30°C
#     • 🌥️ 天气:晴朗
#     """
#     return {"result": message}

"""
企业信用代码查询工具 - 多源查询实现
集成百度、必应、搜狗、360等多个搜索源,提高查询成功率
"""

class CompanyInfoQuery:
    """企业信息查询类 - 多源综合查询"""

    def __init__(self, timeout: int = 15):
        self.timeout = timeout
        self.headers = {
            'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36',
            'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',
            'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8',
        }
        # 创建不验证SSL证书的上下文
        self.ssl_context = ssl.create_default_context()
        self.ssl_context.check_hostname = False
        self.ssl_context.verify_mode = ssl.CERT_NONE

    def _make_request(self, url: str, params: Optional[Dict] = None) -> Optional[str]:
        """发送HTTP请求"""
        try:
            if params:
                query_string = urllib.parse.urlencode(params)
                full_url = f"{url}?{query_string}"
            else:
                full_url = url

            request = urllib.request.Request(full_url, headers=self.headers)
            # 使用忽略SSL证书验证的上下文
            response = urllib.request.urlopen(request, timeout=self.timeout, context=self.ssl_context)
            content = response.read()

            # 尝试多种编码
            for encoding in ['utf-8', 'gbk', 'gb2312', 'latin-1']:
                try:
                    return content.decode(encoding)
                except:
                    continue

            return content.decode('utf-8', errors='ignore')
        except Exception as e:
            return None

    def _extract_credit_code(self, text: str) -> Optional[str]:
        """从文本中提取信用代码"""
        patterns = [
            r'统一社会信用代码[::\s&;]*([A-Z0-9]{18})',
            r'信用代码[::\s&;]*([A-Z0-9]{18})',
            r'统一信用代码[::\s]*([A-Z0-9]{18})',
            r'营业执照注册号[::\s]*([A-Z0-9]{18})',
            r'\b([0-9]{2}[0-9A-Z]{16})\b',
        ]

        for pattern in patterns:
            matches = re.findall(pattern, text, re.IGNORECASE)
            for match in matches:
                if self._validate_code(match):
                    return match.upper()
        return None

    def _validate_code(self, code: str) -> bool:
        """验证信用代码"""
        if len(code) != 18:
            return False
        if not re.match(r'^[A-Z0-9]{18}$', code):
            return False
        # 过滤无效模式
        invalid = ['00000000', '12345678', '11111111', '22222222', '88888888', '99999999']
        for pattern in invalid:
            if pattern in code:
                return False
        return True

    def query_baidu(self, company_name: str) -> Optional[str]:
        """百度搜索"""
        url = "https://www.baidu.com/s"
        params = {'wd': f'{company_name} 统一社会信用代码', 'rn': 10}
        html = self._make_request(url, params)
        if html:
            return self._extract_credit_code(html)
        return None

    def query_bing(self, company_name: str) -> Optional[str]:
        """必应搜索"""
        url = "https://cn.bing.com/search"
        params = {'q': f'{company_name} 统一社会信用代码', 'count': 10}
        html = self._make_request(url, params)
        if html:
            return self._extract_credit_code(html)
        return None

    def query_sogou(self, company_name: str) -> Optional[str]:
        """搜狗搜索"""
        url = "https://www.sogou.com/web"
        params = {'query': f'{company_name} 统一社会信用代码', 'num': 10}
        html = self._make_request(url, params)
        if html:
            return self._extract_credit_code(html)
        return None

    def query_360(self, company_name: str) -> Optional[str]:
        """360搜索"""
        url = "https://www.so.com/s"
        params = {'q': f'{company_name} 统一社会信用代码', 'pn': 1}
        html = self._make_request(url, params)
        if html:
            return self._extract_credit_code(html)
        return None

    def query_company(self, company_name: str) -> Optional[str]:
        """
        综合多源查询企业信息

        参数:
            company_name: 公司名称

        返回:
            统一社会信用代码,未找到返回None
        """
        # 按优先级尝试不同的搜索源
        sources = [
            ('百度', self.query_baidu),
            ('必应', self.query_bing),
            ('搜狗', self.query_sogou),
            ('360', self.query_360),
        ]

        for source_name, query_func in sources:
            try:
                result = query_func(company_name)
                if result:
                    return result
            except:
                continue

        return None

# 全局查询器实例
_query_client = None

def get_query_client() -> CompanyInfoQuery:
    """获取查询客户端单例"""
    global _query_client
    if _query_client is None:
        _query_client = CompanyInfoQuery()
    return _query_client

def search_company_info(company_name: str) -> str:
    """
    根据公司名称查询企业的统一社会信用代码。

    参数:
        company_name: 公司名称(必须准确,建议包含地区信息以提高准确性)

    返回:
        统一社会信用代码字符串,如果未找到则返回"未找到"
    """
    try:
        client = get_query_client()
        result = client.query_company(company_name)

        if result:
            # return result
            return {"credit_code": result}
        else:
            return {"credit_code": "未找到"}

    except Exception as e:
        return {"credit_code": "查询失败"}

def company_query_tool(args):
    params = args.params

    # 修复 1: 安全获取 name,提供默认值
    company_name = params.get("company_name", "")

    # 修复 2: 直接获取字典,无需 json.loads/json.dumps 循环
    ret = search_company_info(company_name)

    # ret = {
    #     "credit_code": greeting_data
    # }

    # 如果必须返回 Output 类型实例,可以强制转换,否则直接返回 dict 也可被接受
    return ret

def free_weather_tool(args):
    params = args.params
    # 复制原 params 并修改 data 字段
    log = dict(params)  # 或 params.copy()
    # 修复 1: 安全获取 name,提供默认值
    location = params.get("location", "111")

    # 修复 2: 直接获取字典,无需 json.loads/json.dumps 循环
    ret = free_weather_query(location)

    log["data"] = params  # 直接赋值
    result = bmcp.log_write_log_file(log)
    # ret = {
    #     "result": "123"
    # }
    # 如果必须返回 Output 类型实例,可以强制转换,否则直接返回 dict 也可被接受
    return ret
3.插件下添加工具
代码开发完成后,可以在插件下添加工具。
注意:工具名称和入参必须和代码中的方法保持一致。
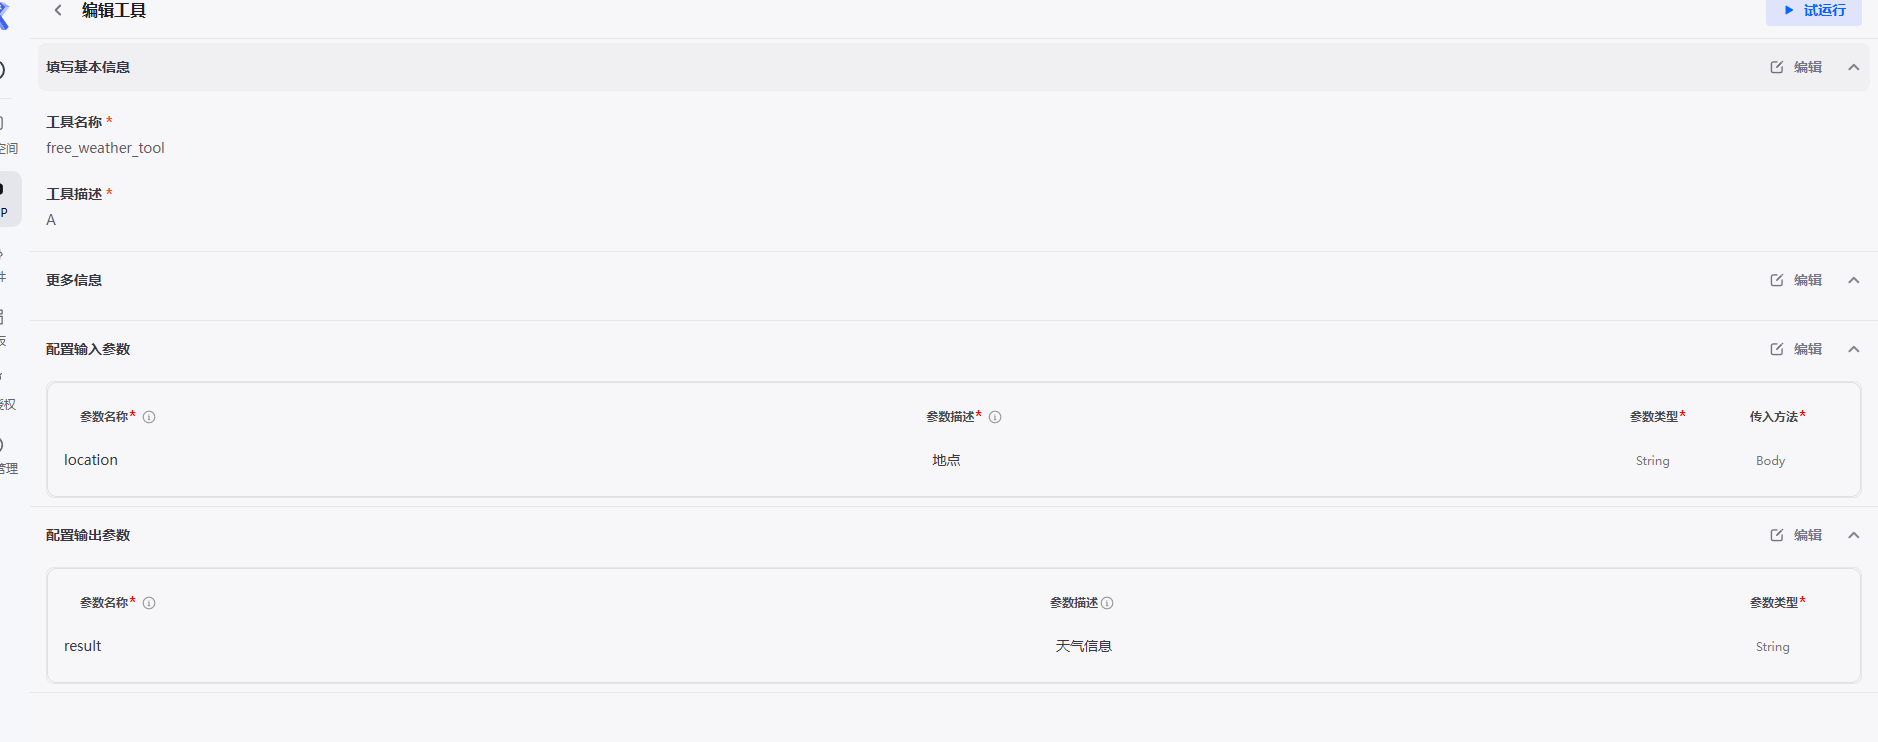
| 参数名 | 值 |
|---|---|
| 工具名称 | free_weather_tool |
| 工具描述 | 自定义,简要描述工具功能 |
输入参数:
| 参数名称 | 参数描述 | 参数类型 | 传入方法 |
|---|---|---|---|
| location | 地点 | string | Body |
输出参数:
| 参数名称 | 参数描述 | 参数类型 |
|---|---|---|
| result | 天气信息 | String |
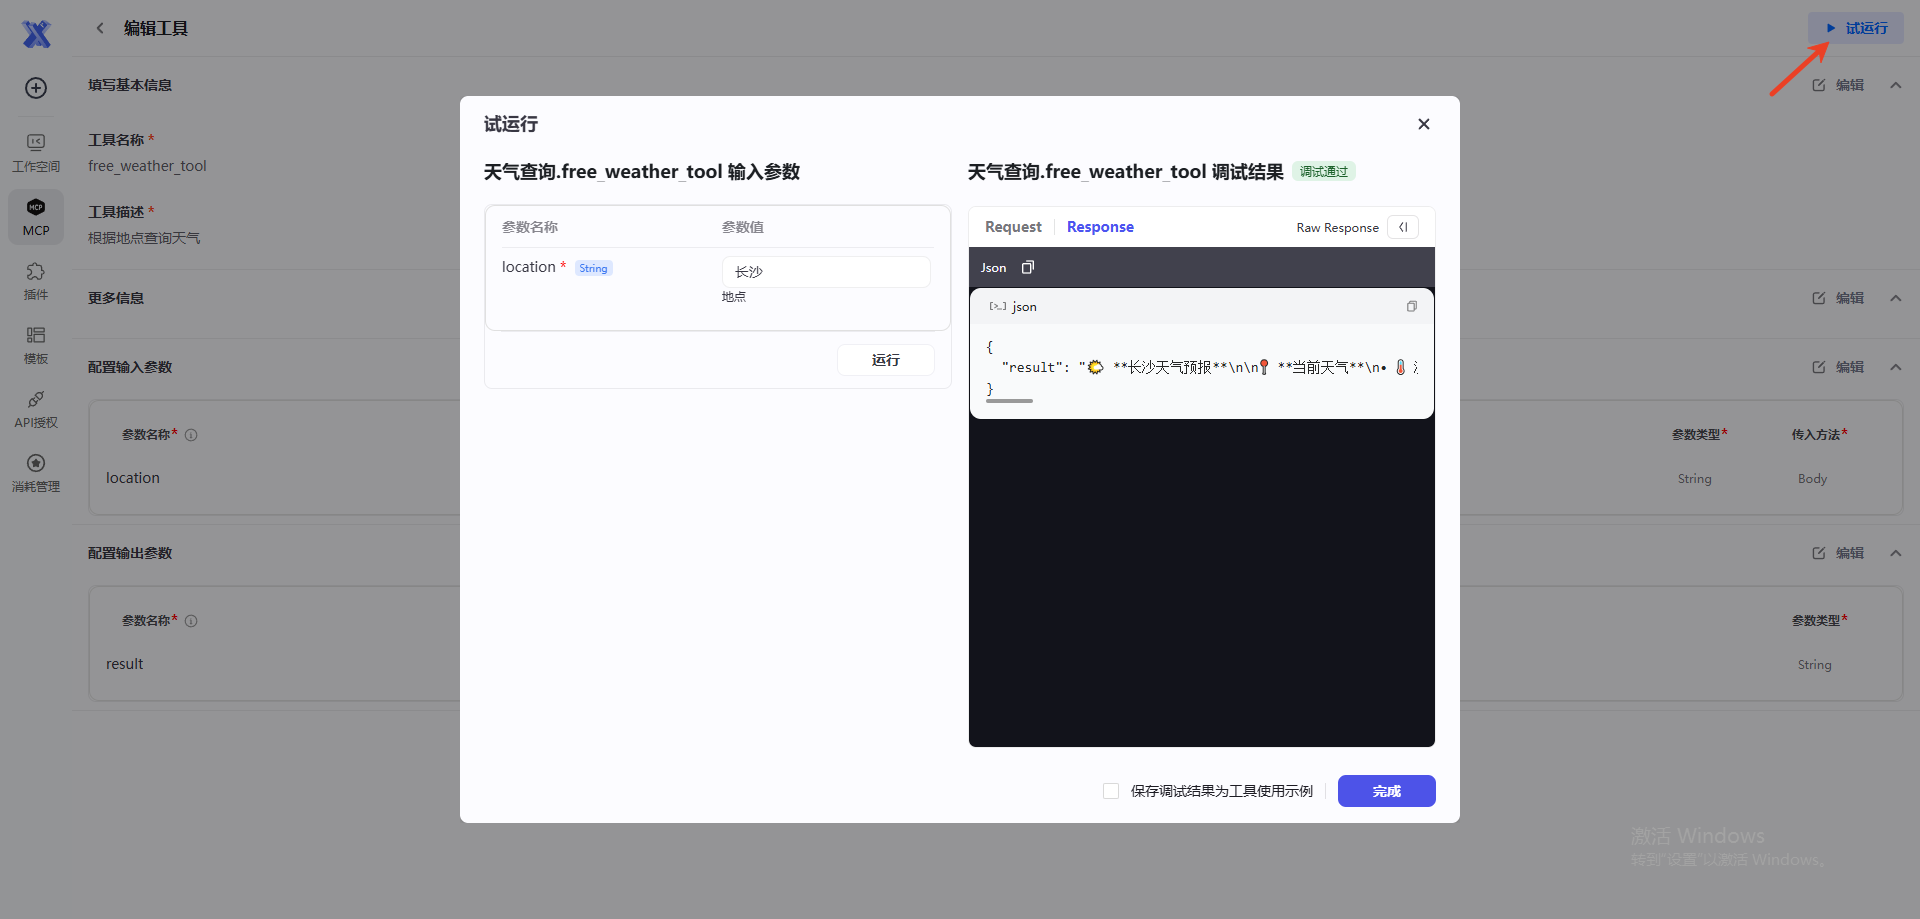
工具添加完成后,点击试运行,验证工具运行是否正常。
4.发布插件
插件下的工具都试运行成功后,发布插件。
插件发布后可供智能体使用。